腾讯把旗舰大模型Hy4开源了,7700亿参数到底意味着什么
11月20日,腾讯混元团队宣布新一代旗舰大模型Hy4正式开源,模型权重同步上线GitHub、Hugging Face、ModelScope和GitCode四…
11月20日,腾讯混元团队宣布新一代旗舰大模型Hy4正式开源,模型权重同步上线GitHub、Hugging Face、ModelScope和GitCode四个平台,开发者可以自行下载部署。随着这次开源,混元的大语言模型系列完成了全量开放。这条消息在技术圈刷屏,但它和普通人到底有多远,需要从参数、门槛和用途三方面拆开看。
开源的是什么:一个7700亿参数的大家伙
先把最基本的信息交代清楚。Hy4正式版最早在11月4日发布,这次开放的是此前预告过的模型权重。它采用MoE混合专家架构,可以简单理解为模型内部有很多个专精不同任务的小网络,每次处理内容时只调用其中一小部分,用这种办法在保持能力的同时压低计算开销。具体数字上,Hy4的语言主干总参数约7700亿,每个词元实际激活约490亿;整个模型有78层,每层配备256个路由专家加1个共享专家,每个词元从中挑选8个来工作。
除了语言部分,Hy4这次还带上了视觉能力,内置一个约12亿参数的视觉编码器,因此能处理图片和视频,官方举的应用场景包括在命令行和图形界面里操作电脑、前端与游戏开发、金融办公以及长时间运行的个人助理任务。上下文窗口达到约105万词元,也就是一次性可以读进去相当长的一整本书或大段代码。为了加快生成速度,模型还内置了一个约33亿参数的小型草稿模型,用推测解码的方式先猜后验,减少等待时间。腾讯方面表示,这次开源同时发布了安全评估卡片,披露了网络安全、生物安全等维度的评估结果。
和预览版比,这次升级了哪些地方
和今年早些时候放出的Hy4预览版相比,正式版主要做了三件事:扩大了预训练和后训练的规模、补上了视觉理解能力、改进了指令遵循和长文本任务。腾讯在官方模型卡里给出了一组自测数据,称在自建的游戏开发评测GameDev上比预览版提升19.1%,GameLogic上提升9.8%。需要说明的是,这些都是腾讯自己测的数字,第三方评测机构近期调整了评测体系,部分中国模型的评分出现波动,因此不同榜单之间的结论未必完全一致。
与旗舰版一同开放的还有一款主打性价比的Hy4 flash。它的总参数约2240亿,其中含约640亿的Engram参数,每个词元只激活约120亿参数,同样支持最高100万词元的上下文,也能处理文本和图像。腾讯披露,在涉及85名内部用户、259项工作任务的盲测里,Hy4 flash完成单个任务的成本约为Hy4的二十分之一,平均约0.26元。这个数字的意义在于,大模型要真正普及,成本必须降到普通人和企业都负担得起的程度,flash这类小体型版本承担的就是规模化落地的角色。
开源协议里的细节,别只看「免费」两个字
这次开源还有一个容易被忽略的点,就是许可证。多家媒体报道时对协议的描述并不一致:有的说采用宽松的Apache 2.0协议,允许商业使用和修改;也有报道依据模型卡原文指出,Hy4使用的是腾讯自己的Tencent Hy License,这个协议衍生自Apache 2.0但并非标准Apache协议,其中额外约定,把模型作为通用服务对外提供的公司,如果全球年营收超过5000万美元或者产品月活跃用户超过1亿,需要另外取得腾讯的书面授权,纯内部使用则不受此限制。对普通开发者来说,下载、研究、内部试用基本没有障碍;真要把模型包装成对外收费的大规模服务,就需要先看清条款。
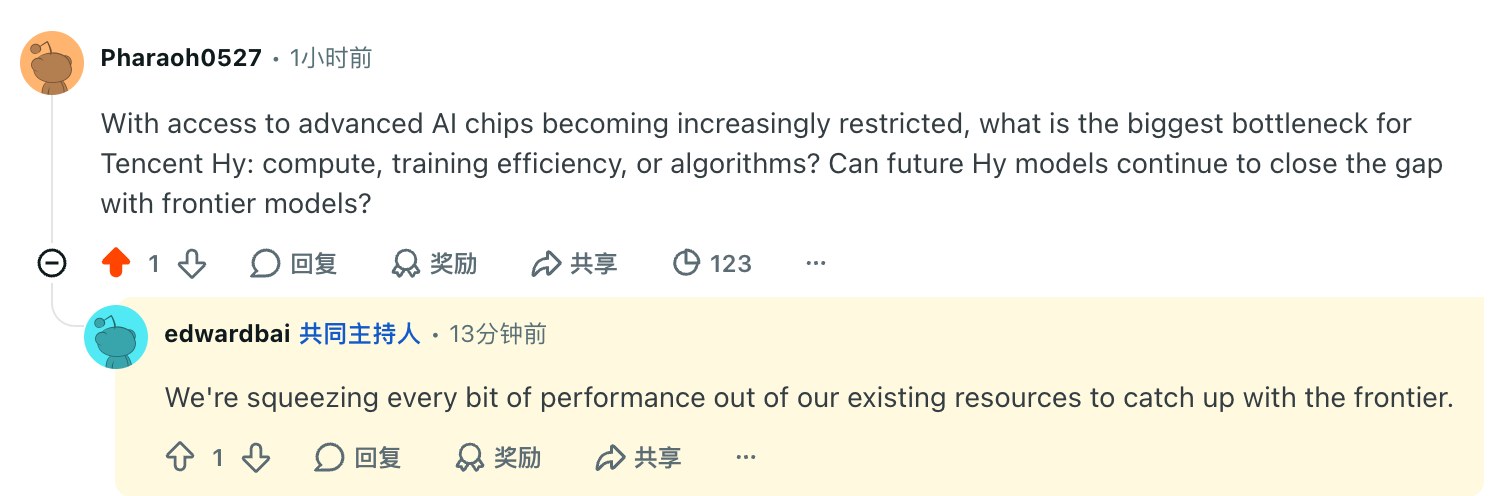
腾讯在模型卡里也坦承了局限。官方明确写着,Hy4与顶级闭源模型之间仍有明显差距,尤其是在研究级数学、长周期编程和高难度视觉问答这类任务上。今年11月21日凌晨,腾讯混元团队在社交平台举行了一场面向全球开发者的问答活动,团队负责人之一姚顺雨也参与了讨论。活动中团队回应,在先进芯片获取受限的情况下会尽可能充分利用现有资源追赶前沿,下一代模型还会进一步扩大参数规模并继续投入大规模强化学习,同时面向24GB显存设备的小模型等产品也在规划之中。
门槛有多高:个人电脑基本跑不动
对技术好奇的读者可能会问,能不能在自己电脑上装一个玩玩。答案是比较难。Hy4这类旗舰模型的体量决定了普通个人电脑基本跑不动,腾讯给出的部署方案主要是vLLM、SGLang这类面向服务器和集群的工具,并提供了FP8量化版本来降低显存占用,更偏向企业和研究机构。真正适合普通设备的,是腾讯规划中的小型版本,比如面向24GB显存设备的模型,这类产品才有可能出现在未来的个人电脑上。换句话说,开源的直接受益者是开发者和企业,而不是马上就能在自家电脑上用的普通用户。
把这件事放到更大的背景看,国产开源大模型这两年走的是一条「你追我赶」的路线。多家国内厂商陆续把主力模型开放出来,开源几乎成了中国大模型的一种集体选择。这种做法的好处是降低了各行各业接入AI的门槛,让中小企业不必从零训练模型;挑战则在于,开源之后如何形成可持续的商业模式,以及如何在算力受限的条件下继续缩小和顶尖模型的差距。腾讯这次把旗舰模型连同小而便宜的版本一起开放,某种程度上就是对这个问题的回应。
Related Articles
广东「十五五」规划里的AI:换医院少做检查、办事少跑腿,这些变化看得见
近日,《数字广东建设「十五五」规划》正式发布,目标是到2030年让人工智能全面重塑生产生活范式,把「数字广东」升级为「数智广东」。这类规划听起来宏大,但里面…
机器人从「会表演」到「能上岗」:这场量产竞速离普通人还有多远
11月19日至21日,2026世界智能制造大会在南京举行,5.5万平方米展区汇聚600余家企业,最大的看点是机器人从「会表演」转向「能干活」。与此同时,在深…
给能办事的AI戴上「紧箍」:20家企业联合公约,管的就是越权和隐私
当AI只是陪你聊天,出点岔子顶多是无伤大雅;但当它能替你下单、转账、改设置,问题就变了。今年11月的世界互联网大会乌镇峰会上,中国信息通信研究院联合腾讯、蚂…