应用截图
应用介绍
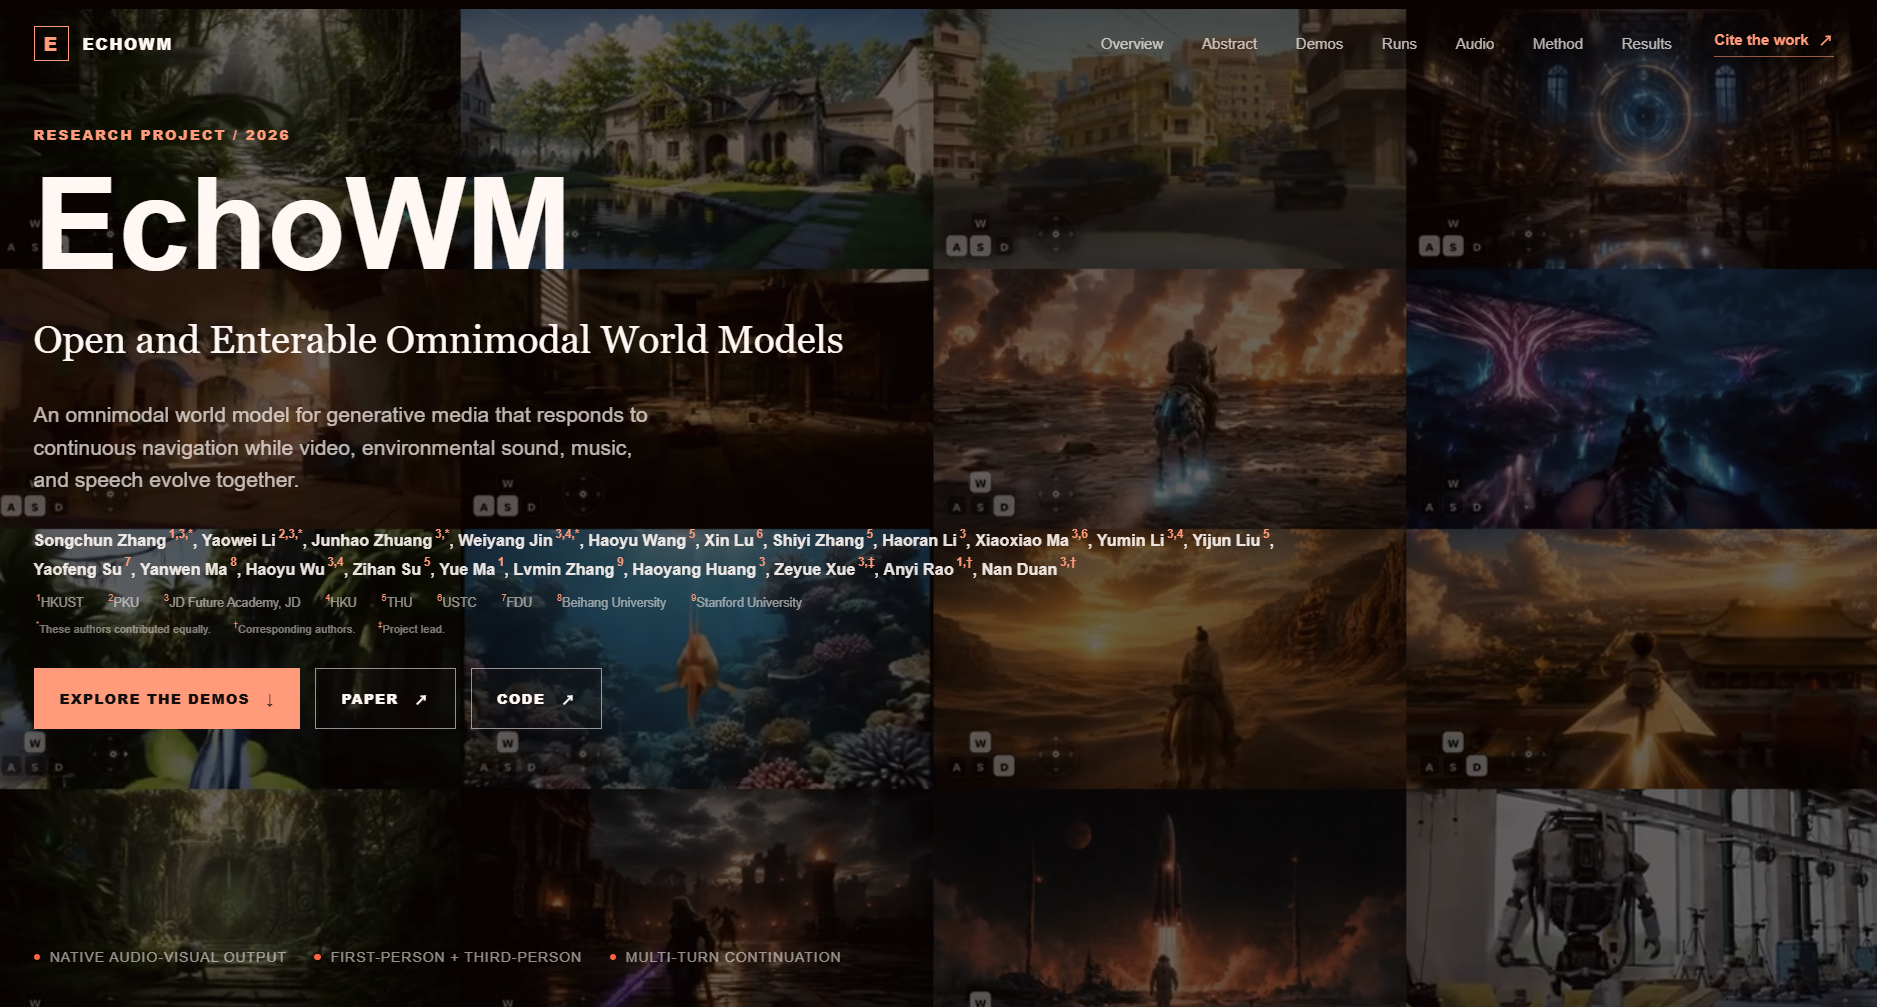
EchoWM 是 Echo Team、Joy Future Academy 与京东相关团队发布的世界模型研究项目,主要面向生成式媒体研究者、AI 开发者和对交互式虚拟世界感兴趣的用户。它针对现有生成视频大多只能被动观看、缺少连续操控和同步声音的问题,尝试让生成内容真正“进入其中并与之互动”。
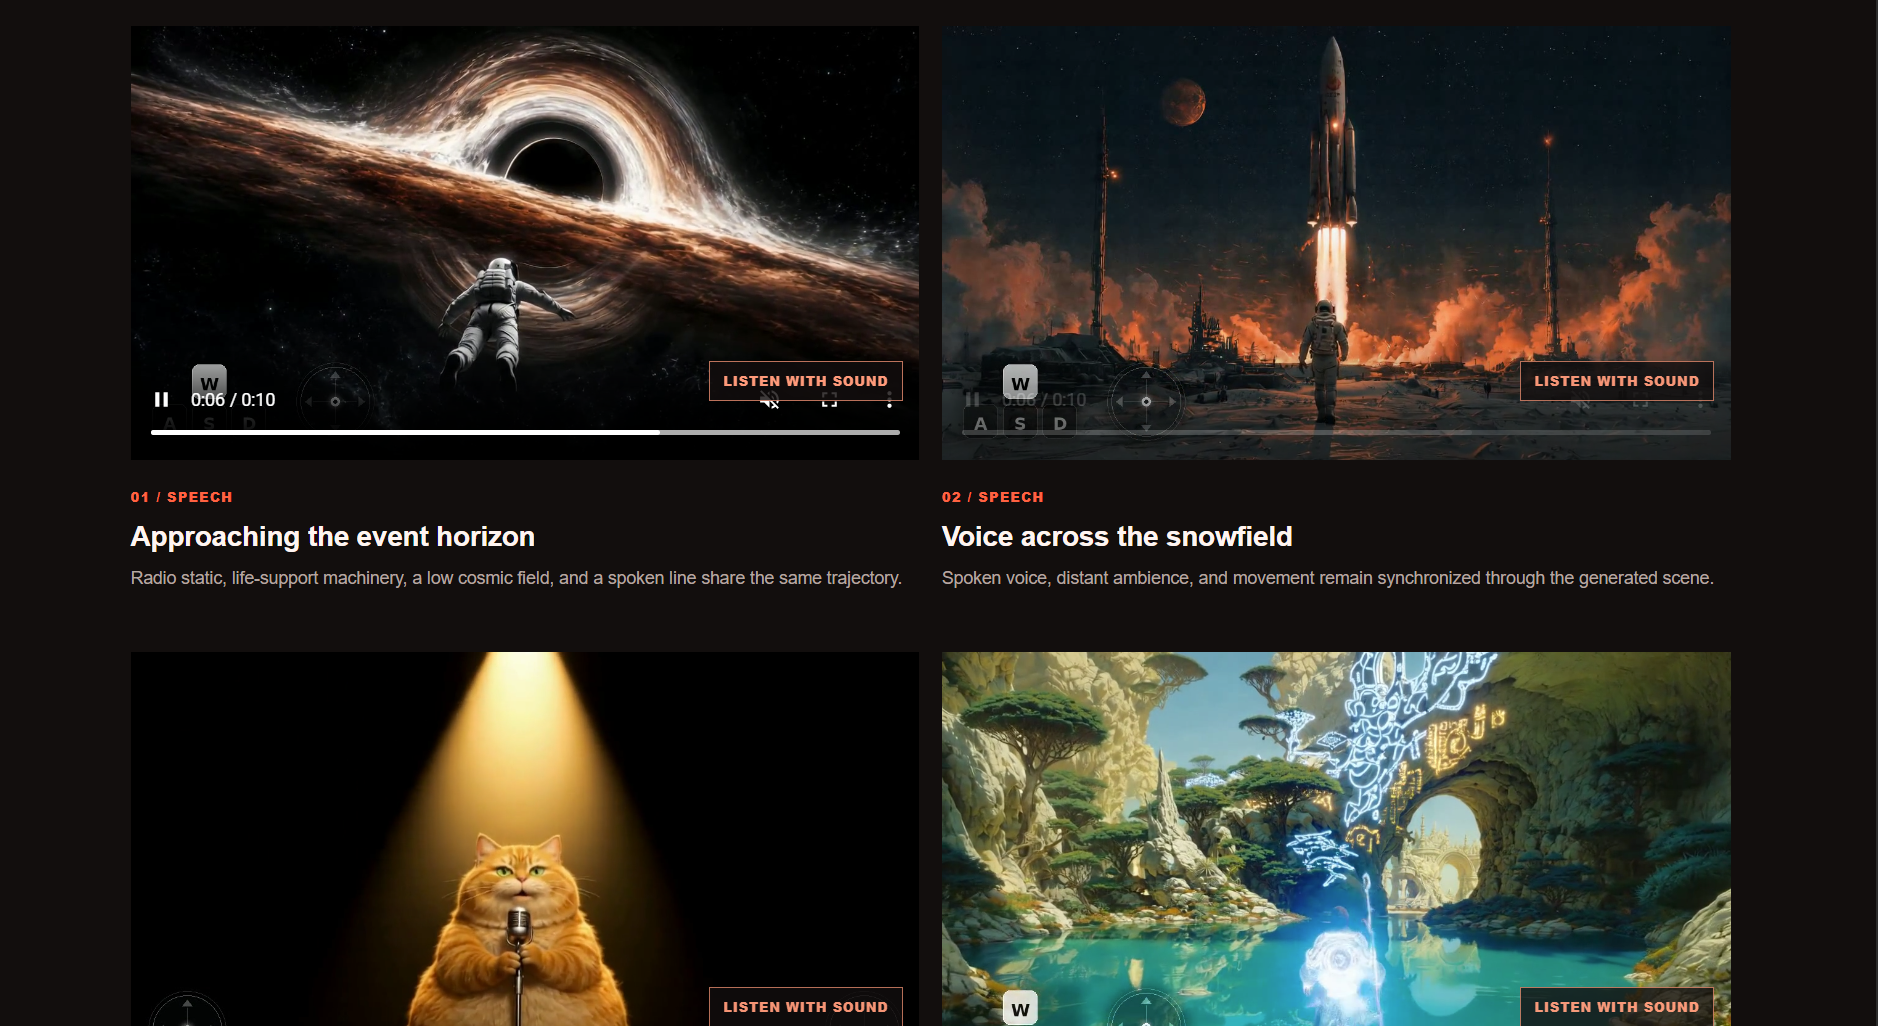
用户可以从一段参考画面、场景描述和控制信号出发,让模型持续生成可导航的世界。EchoWM 会同步生成 720p 视频、环境音、音乐和语音,并支持第一人称、第三人称视角以及多轮续写。
核心功能
连续视角控制:通过离散指令或连续动作控制镜头移动,让生成场景能够按照用户意图持续推进。
音视频同步生成:在生成画面的同时加入环境音、音乐和人物语音,使声音随镜头和场景变化保持同步。
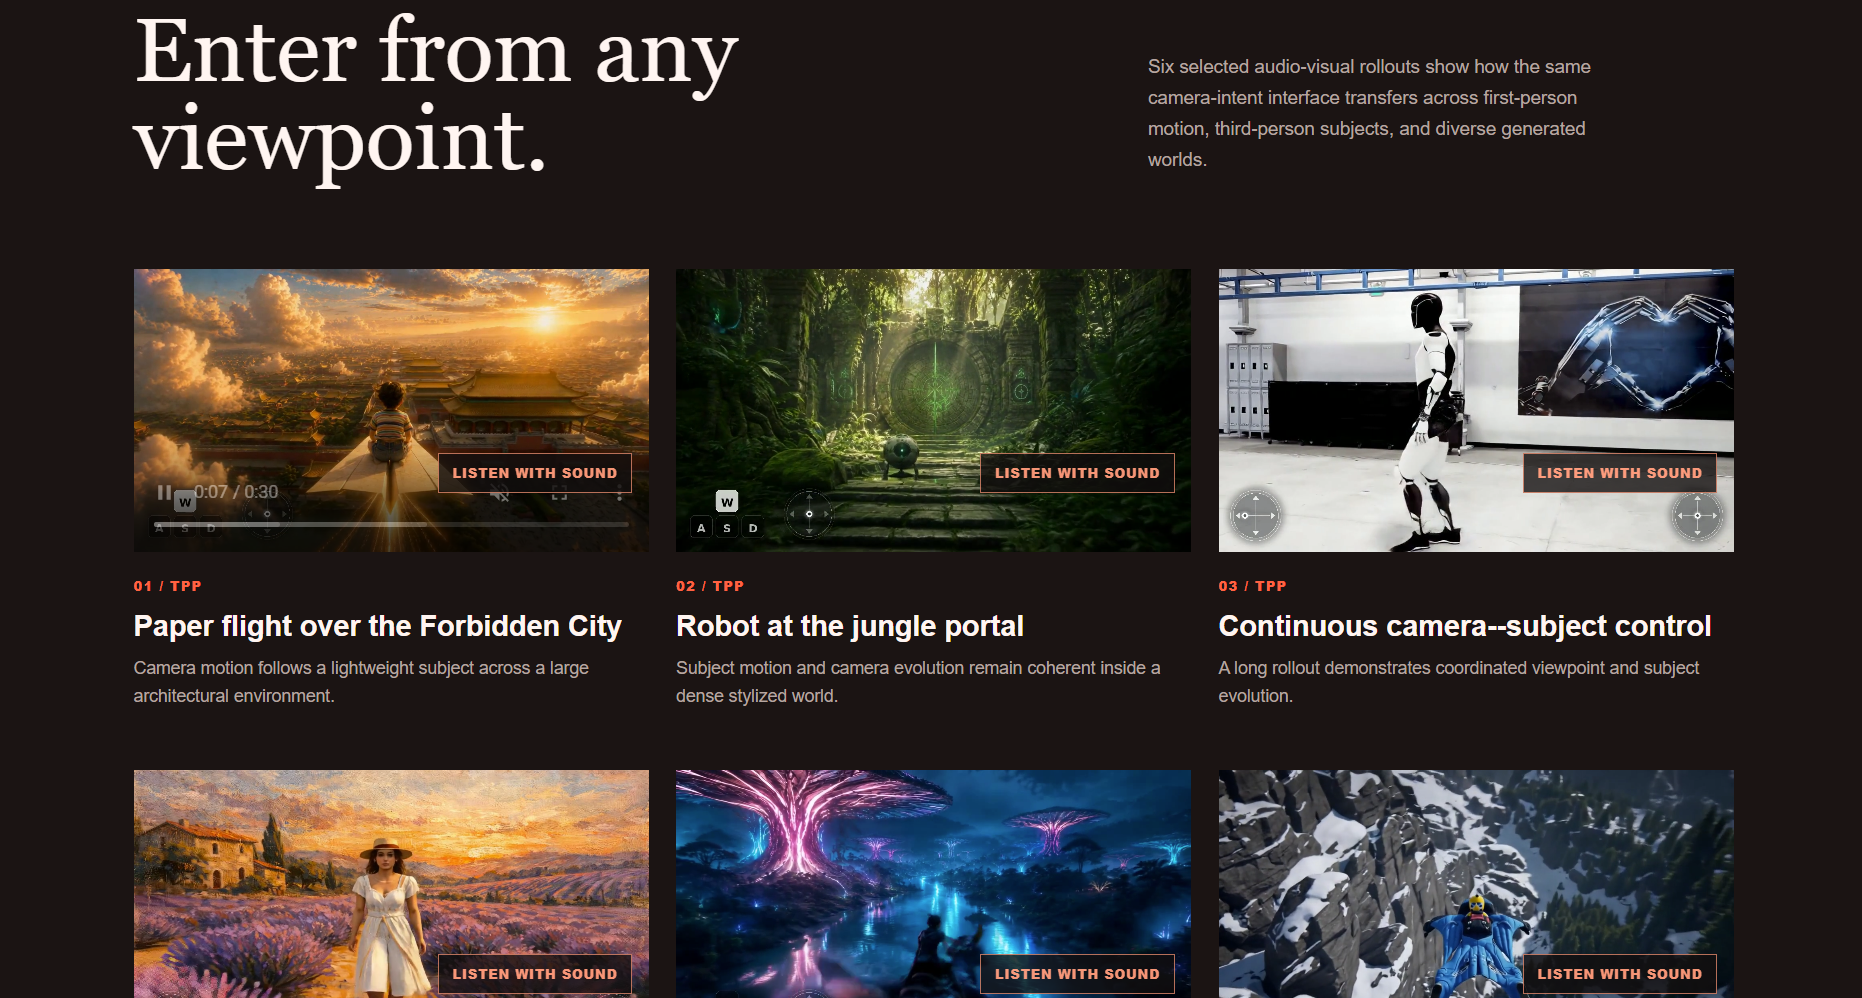
第一与第三人称交互:支持观察者视角移动,也能处理镜头与角色之间的运动关系,适配不同类型的虚拟世界。
长时段场景延续:通过多轮续写保持场景、角色和声音状态,生成较长时间的连续世界体验。
交互式案例展示:页面提供多个真实、游戏和风格化场景演示,用户可以浏览生成过程并播放对应音频。
适合谁
研究世界模型、视频生成和多模态交互的科研人员。
关注生成式媒体、虚拟世界和 AI 游戏技术的开发者。
希望了解连续导航与音视频联合生成能力的技术爱好者。
需要研究交互式内容方向、寻找灵感的创作者和产品团队。
使用方式
打开 EchoWM 项目页面,进入演示和案例区域。
浏览不同视角、场景和控制方式下的生成视频。
点击音频播放,体验环境声、音乐和语音与画面的同步效果。
查看项目方法、实验结果和论文资料,了解其技术实现。
当前资料中暂未提供面向普通用户的在线创作或模型调用流程。
本页资料整理自 观猹 watcha.cn,仅作收录与介绍;应用名称、图标、截图及相关商标归原作者所有,如有异议可联系本站处理。